RAG構築の進め方|社内資料を活用する仕組みと誤回答を減らす設計


社内の規程やマニュアルをAIに読ませて、質問に答えさせたい。そう考えて調べ始めると「RAG」という言葉に行き当たります。
一方で、作ってみると「資料には書いてあるのに、違う答えが返ってくる」という状態が起こります。いろいろな人が活用する目的で社内の規程やマニュアルをAIで処理して、手早くわかりやすく参照できる社内ツールにしようとしたのに、間違った情報や資料にない情報が出てきてばかりだと、役に立たないだけでなく、トラブルにもなり得ます。
違う答えが出力されるのは、1か所の問題で起きるとは限りません。原因になりうるのは、元の資料、取り込みと分割、検索、回答生成の4つです。
直して効果が出たか、別の質問に悪影響が出ていないかを確かめるには、評価と変更管理の仕組みも要ります。原因はどこなのかを確認せずに直し始めると、効果のない対策に時間を使うことになります。
この記事では、RAGの仕組みと構築の手順を整理したうえで、社内資料を活用したAI回答のシステムで誤回答が出てしまうときに調べる5つの確認点を扱います。評価の設計と、構築方法の選び方もまとめました。
AIを使った仕組みづくりをお考えなら、
私たちEnlytにご相談ください。お客様の業務内容や目的を伺い、必要な機能と進め方を一緒に整理します。どんな開発をしてきた会社か、実績とサービス内容をご覧ください。
目次
RAGとは
RAGは、Retrieval-Augmented Generation(検索拡張生成)の略です。質問に関係のありそうな文書を先に検索し、その内容を一緒に渡してAIに答えさせる仕組みを指します。
AIが知っている知識だけで答えるのではなく、手元の資料を根拠として読ませます。社内の規程やマニュアルのように、公開されていない情報を扱う場面で使われます。
LLM単体との違い
LLM(Large Language Model / 大規模言語モデル)単体は、学習済みの知識と入力された情報をもとに回答します。社内資料を渡したり、参照できる仕組みにつないだりしていなければ、その内容に基づく回答は期待できません。
RAGでは、質問に関係する資料を検索し、その内容を入力に加えます。AIは渡された資料を読んで答えるため、根拠のある回答に近づきます。
渡した資料に答えが書かれていない場合、根拠不足のまま回答すると誤回答につながります。RAGは誤回答を減らす仕組みですが、なくす仕組みではありません。誤回答への対処は後半で詳しく扱います。
ファインチューニングとの違い
社内の情報をAIに扱わせる方法として、ファインチューニングと比べられることがあります。目的が違うため、どちらが優れているという関係ではありません。
| 観点 | RAG | ファインチューニング |
|---|---|---|
| 主な目的 | 手元の情報を根拠に答えさせる | 答え方や形式を学ばせる |
| 情報の更新 | 文書を取り込み直せば反映される | 学習をやり直す必要がある |
| 出典の提示 | 参照した文書を示せる | 示しにくい |
情報の更新について補足します。この記事が扱う構成では、取り込み直しとベクトルの作り直しが要るため、ファイルを差し替えるだけでは反映されません。学習をやり直す場合と比べて手間が小さい、という違いです。
社内の資料から回答を出す形にしたいのであれば、まずRAGから検討します。資料が頻繁に変わる環境では、更新内容を検索対象に反映できるかどうかが、運用にかかる手間を左右します。
回答の口調や形式を揃えたい場合は、プロンプトで指示するところから始めます。それで足りない場合に、ファインチューニングを検討する順序です。
RAGの構成要素と処理の流れ
ここでは、社内文書を取り込み、ベクトル検索などで必要な箇所を探す構成を例に、取り込み・検索・生成に分けて説明します。
RAGの情報源は文書に限らず、APIやデータベースなども含まれます。すべてのRAGで同じ取り込み処理が必要になるとは限りません。
どの段階で何をしているかを押さえておくと、問題が起きたときに切り分けられます。
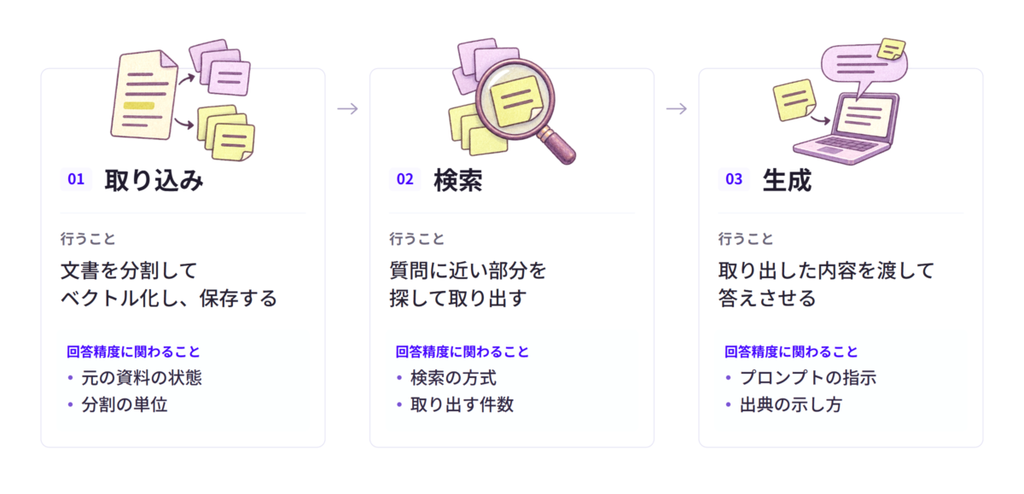
| 段階 | 行うこと | 精度に効く部分 |
|---|---|---|
| 取り込み | 文書を分割してベクトル化し、保存する | 元の資料の状態、分割の単位 |
| 検索 | 質問に近い部分を探して取り出す | 検索の方式、取り出す件数 |
| 生成 | 取り出した内容を渡して答えさせる | プロンプトの指示、出典の示し方 |
取り込みの段階 「チャンク」と「ベクトル」
社内の文書を読み込み、意味のまとまりごとに区切った一つひとつを「チャンク」と呼びます。
各チャンクを埋め込みモデルに通して、数値の並び(ベクトル)に変換します。この変換によって、文章の意味の近さを計算で比べられるようになります。
変換したベクトルは、ベクトルデータベースなどに保存します。保存までが、質問を受ける前の準備になります。
検索の段階
質問を受けると、質問そのものも同じ埋め込みモデルでベクトルに変換します。保存してあるチャンクのベクトルと比べ、意味が近いものを上から数件取り出します。
意味の近さの計算にはコサイン類似度などが使われます。取り出す件数は設計で決める値で、少なすぎると答えが含まれず、多すぎると関係のない内容が混ざります。
生成の段階
取り出したチャンクを質問と一緒にプロンプトへ入れ、生成AIに渡します。AIは渡された内容を読んで回答を作ります。
プロンプトの指示の書き方によって、回答の質が変わります。
資料に答えがない場合の応答方針も、プロンプトに記載します。実際に方針どおり応答するかは、評価で確認します。
構築の前に決めること
決めごとが曖昧なまま作ると、できあがってから作り直すことになってしまいますので、実際に構築を始める前に決めておきたい項目があります。
対象にする資料の範囲
社内の文書をすべて入れると精度が上がる、という形にはなりません。古い版や下書き、矛盾する記述が混ざると、現行版の情報ではない内容が検索で引っかかって誤回答の元になります。
最初は、答えてほしい質問がはっきりしている範囲に絞ります。就業規則だけ、特定の製品のマニュアルだけ、といった絞り方です。範囲は後から広げられます。
誰を対象に活用するものなのか
全社員が使うのか、特定の部署だけかで、必要な造りが変わります。部署ごとに見せてよい資料が違う場合は、権限に応じて検索の対象を分ける必要があります。
閲覧権限に応じた制御を後から追加すると、設計の見直しが必要になる場合があります。将来的に分けるのであれば、最初の設計に入れておきます。
何を正解とするか
精度を上げたいと考える場合、何が正解かが決まっていなければ測れません。想定する質問と、そのときに出てきてほしい回答の組を、先に用意してテストできるようにしておきます。
質問数は、対象業務や資料の幅に合わせて決めます。通常の質問だけでなく、例外、曖昧な質問、答えのない質問も含めます。
確認できていないケースが見つかるたびに追加していきます。この組は、作ったあとで何度も使うことになります。先に用意しておくほど後が楽になります。
どこまでの精度で運用に乗せるか
社内の問い合わせを減らす目的であれば、間違いが混ざっても出典から確かめられる形で足りることがあります。一方で、回答をそのまま顧客に伝える用途では、求められる水準が変わります。
用途によって必要な水準が違うため、先に決めておきます。全社に配る前に、限られた範囲で使ってもらう期間を置く進め方もあります。
人の確認を挟むか、自動で表示するかも、求める水準と一緒に決まります。挟む前提にするなら、確認する人の負担も運用の設計に入れます。
構築の手順
決めることが揃ったら、順に構築していきます。各段階で後の精度に効く判断が出てきます。
資料の整理
対象にする文書を集め、使える形に整えます。古い版を外し、同じことを別の言い方で書いている箇所を揃えます。
PDFの場合は、文字として取り出せるかを確認します。スキャンしたPDFでも、文字が読める状態ならばOCRや読み取りソフトなどでデジタルテキストとして取り出せます。
表や図の中の文字も、取り出せているかを確かめます。
資料の整理は地味な工程ですが、後の精度を左右します。元の資料が整っていない状態で先に進むと、どこに原因があるのか分からなくなります。
チャンク分割
文書を検索しやすい単位に区切ります。区切り方には、文字数で機械的に切る方法と、見出しや章の構造に沿って切る方法があります。
短く切ると、検索では当たりやすくなりますが、前後の文脈が切れて意味が通らなくなります。長く切ると文脈は残りますが、関係のない内容が一緒に渡されます。
社内の規程のように条文の構造がある文書では、構造に沿って切るほうが扱いやすくなります。章や条の見出しをチャンクに含めておくと、どこから来た情報かが分かります。
埋め込みモデルの選定
文章をベクトルに変換するモデルを選びます。日本語の文書を扱う場合は、日本語での性能を確認します。
取り込みのときと検索のときで、同じモデルを使います。モデルによっては、文書を変換するときと質問を変換するときで指定する種類が分かれています。文書と質問それぞれの用途に合う指定を使い、必要な情報を検索できるかを確認します。
途中でモデルを変える場合は、保存してあるベクトルを作り直すことになります。
検索の設計
意味の近さだけで探す方式では、拾えない質問が出てきます。製品の型番や金額、日付のような固有の値は、意味の近さでは当たりにくくなります。
拾えない質問が出てくる対策として、意味で探す検索と、語そのものを探す検索を組み合わせる方式があります。取り出した候補を並べ替える処理を加えて、確度の高いものを上に持ってくる方法もあります。
取り出す件数も設計で決めます。取り出す件数を増やせば答えが含まれる確率は上がりますが、関係のない内容も増えます。評価の組を使って、実際に試しながら決めます。
プロンプトの設計
取り出した内容をどう読ませるかを指示します。プロンプトに書いておくべきことが3つあります。
- 渡した資料だけを根拠にする
資料に書かれていないことを補って答えないように指示します。これがないと、AIが知っている一般的な話が混ざります。 - 分からない場合は分からないと答える
資料に答えがない場合の振る舞いを決めます。無理に答えさせると、もっともらしい誤りが返ります。 - 参照した箇所を示す
どの文書のどこを根拠にしたかを出力させます。利用する側が確かめられるようになり、誤りにも気づけます。
お役立ち資料(無料)
アプリ開発でのベンダー選定のポイント
開発を外部に頼むときに、何を基準に相手を選び、何を先に決めておくとよいかをまとめた資料です。初めて発注する方向けに書いています。
資料をダウンロードする誤回答を調べる5つの確認点
期待と違う回答が出力されたときに調べる箇所と、改善を確かめる方法を、5つの確認点に整理します。順に確かめていくと、どこを修正するとよいかが絞れます。
手前から順に見ていくのは、前の段階の問題を残したまま後ろを調整しても変わらないためです。元の資料に矛盾があるなら、検索をいくら調整しても安定しません。
なお、事実と違う内容をもっともらしく生成する現象は、ハルシネーションと呼ばれます。本章では、ハルシネーションに加え、必要な情報を検索できない場合や、回答に重要な条件が抜ける場合も含めて、確認方法を説明します。
利用者に届ける前にどう止めるかは、表示と保留の設計の問題になります。
| 確認点 | 確かめること | よくある症状 |
|---|---|---|
| 元の資料 | 質問に適用できる正しい記述があり、版・対象者・適用条件が明確か | 古い内容や、別の対象者向けの内容が返る |
| 取り込み・分割 | その記述を正しく取り出せており、条件や例外が欠けていないか | 文が途中で切れる、例外が落ちる |
| 検索 | 必要なチャンクが取得され、実際に生成AIへ渡されているか | 資料にあるのに「ない」と返る |
| 回答生成 | 渡した根拠に沿い、質問に必要な内容を答えているか | 資料にない説明が混ざる、答えが足りない |
| 評価・変更管理 | 修正前後を同じ質問で比べ、別の質問への悪影響も確認できるか | 直したつもりが直っていない |
5つ目に挙げた「評価・変更管理」は、回答を作る過程そのものではありません。原因を特定し、直したことを確かめるための段階です。評価・変更管理が欠けていると、手前の4つの切り分けが続きません。
確認点1 元の資料
最初に、回答の根拠となった資料を確認します。古い版の規程が残っていて、新旧が両方検索に引っかかると、どちらが返るかは安定しません。
同じ内容を違う言い方で書いた文書が複数ある場合も、同じことが起こります。部署ごとに作ったマニュアルが並んでいる環境では、よく見かける状態です。
対象者や適用条件も確かめます。同じ文面が複数の規程に載っていても、正社員向けと契約社員向けで条件が違えば、別の記述として扱う必要があります。
確かめ方はこうです。回答の根拠に使われた箇所を確認し、資料自体が正しいか、その質問に適用できる内容かを調べます。資料が正しい場合は、取り込み・検索・回答生成の各段階で、必要な条件が落ちていないかを確認します。
対処は、取り込む前に版と適用条件を整えることです。システム側で新しい版を優先する仕組みも作れますが、資料に版の情報が入っていなければ判断できません。
確認点2 取り込み・分割
資料が正しいと分かったら、その記述を正しく取り出せているかを見ます。区切り方が合っていないと、必要な情報が分断されます。「第5条の内容」を聞いたときに、第5条の前半だけが渡されると、回答も途中で終わります。
表が途中で切れる症状も、よく起こります。項目名の行と値の行が別のチャンクに入ると、どの値が何の項目なのか分からなくなります。
条件が複数ある規程でも起こります。「原則」と「ただし書き」が別のチャンクになると、例外を落とした回答が返ります。
確かめ方は、取り出されたチャンクをそのまま見ることです。開発の段階で、何が取り出されたかを記録しておくと切り分けが早くなります。条件や例外の文が欠けていないかを、元の資料と並べて確かめます。
確認点3 検索
必要なチャンクが取得され、実際に生成AIへ渡っているかを見ます。資料には書いてあるのに取り出せていない場合、利用する側からは「AIが知らない」と見えますが、原因は検索の側にあります。
意味の近さで探す方式が苦手なのは、固有の値と否定の表現です。「型番AB-200の保証期間」のような質問では、型番の部分が意味として扱われず、別の型番の記述が返ることがあります。
「〜してはいけない場合」のような否定を含む質問も、肯定の記述と区別されにくくなります。
取り出す件数が少なすぎないかも確認します。正解が6番目にあるのに上位5件だけを渡していれば、AIは答えようがありません。
取り出せていても、渡す段で落ちている場合があります。文字数の上限を超えた分が切られていないか、渡した内容をそのまま記録して確かめます。
対処は、語そのものを探す検索との組み合わせ、取り出す件数の調整、並べ替えの処理です。固有の値を多く含む資料では、語そのものを探す検索を併せると当たりやすくなります。どれが効くかは資料の性質によるため、評価の組で比べます。
確認点4 回答生成
正しい資料を渡しても、内容を読み違えたり、資料にない説明を補ったりすることがあります。プロンプトだけでなく、使用するモデルや渡す情報の量・並び方も含めて確認します。
回答に必要な情報が抜けていないかも確認します。資料にある正しい一文を返していても、質問に対する答えになっていなかったり、重要な例外が抜けていたりします。
「分からない」と答えることを許していないと、AIは何かを答えようとします。渡された資料に答えがない場合でも、知っている知識で埋めます。
矛盾する資料が渡されたときの扱いも決めておきます。どちらを優先するか、両方を示すか、判断できないと伝えるかです。
確かめ方は、同じチャンクを渡したまま指示やモデルを変えて試すことです。ただし「変えたら回答が変わった」だけでは原因の確定になりません。同じ評価用の質問で改善が続くかを、次の確認点で確かめます。
確認点5 評価・変更管理
評価・変更管理は、回答を作る過程ではなく、直したことを確かめる段階です。修正の前後を同じ質問で比べ、別の質問への悪影響も見ます。
評価の組がないと、直したつもりが直っていない、良くなったはずが別の質問で悪くなっている、という状態に気づけません。チャンクの大きさを変えたとき、ある質問は良くなり別の質問は悪くなります。評価の組がなければ、この入れ替わりが見えません。
変更の記録も残します。何を変えたのかが分からないと、良くなった理由も悪くなった理由も追えなくなります。
評価と変更の記録がないままでは、現場からの指摘に個別対応しても、全体として改善しているかを判断できません。
対処は、構築の前に評価の組を用意しておくことです。
セキュリティと権限の設計
社内の資料を対象にするため、誰が何を見られるかの権限や公開範囲の設計が要ります。RAGのセキュリティで先に詰めるのは、この権限の分離です。
閲覧権限に応じた制御は、動くものができてから追加すると、取り込みの作り直しになる場合もあります。
見せてよい範囲の分け方
人事評価や給与、契約書のように、部署や役職によって見せられない資料があります。これらを同じ場所に取り込むと、検索で引っかかって回答に出てきます。
閲覧権限についての対策は、検索する対象を利用者ごとに絞ることです。チャンクに部署や役職の情報を持たせ、検索のたびに条件として渡す形が一般的です。
ただし、この絞り込みは認証や認可の代わりにはなりません。条件として渡す文字列が一致するかを見ているだけです(Microsoft|検索結果のセキュリティフィルター)。
検索条件に使う権限は、認証済みの利用者情報と元の資料の閲覧権限から、システム側で決定します。利用者が入力した部署名などを、そのまま権限として信用しない設計にします。
資料の削除や権限変更が検索対象に反映されることも確認します。元の資料で権限を外したのに、取り込んだ側に残っていれば見えてしまいます。
絞り込みをすべての検索に掛け忘れないことも、設計に含めます。使う製品に文書単位の権限機能がある場合は、そちらを先に検討します。自分で条件を組むより、掛け忘れが起きにくくなります。
簡単なのは、見せられない資料は取り込まないことです。範囲を絞って始める進め方は、この点でも扱いやすくなります。
取り込んだ文書に不正な指示が混ざる場合
取り込んだ文書に、AIの指示を上書きしようとする文章が含まれる場合もあります。外部から受け取ったファイルや、ウェブから取り込んだ内容、社内でのAIの使い方マニュアルなどが対象に入っているときは注意します。
AIの指示を上書きしてしまう対策は、検索結果を回答の材料として扱い、権限の変更や外部への送信を任せない構成にすることです。あわせて、不正な指示を含む文書でも想定どおり動くかを確認します。
RAGを使えばこの問題が防げるわけではありません。この問題についてOWASPのプロンプトインジェクションの解説で取り上げられていました。
外部のサービスに資料を渡す場合
生成AIを外部のサービスで動かす場合、社内の資料がそのサービスに送られます。入力した内容がどう扱われるかは、提供元と契約の条件によって変わります。
学習に使われるかどうか、どこの国のサーバーで処理されるか、保存される期間はどれくらいか。この3点を、利用規約とデータの取り扱いに関する資料で確認します。
契約の種類や設定によって変わる項目もあります。一般的な説明ではなく、自社の契約条件に当てはめて読みます。
社内の規程で外部への持ち出しが制限されている資料がある場合は、先に情報システムの部署と扱いを決めます。自社の環境で動かす構成も取れますが、運用の負担は変わります。
社外の資料が混ざらないようにする
社内の資料だけを対象にしていても、過去に受け取った他社の資料や、守秘義務のある提案書が同じ共有フォルダに置かれていることがあります。取り込む範囲をフォルダ単位で決めると、こうした資料がまとめて入ります。
取り込む前に、対象のフォルダの中身を一度見ておきます。手間はかかりますが、あとから取り除くより確実です。
評価の設計
何を測るか
RAGがうまく動いているかの評価は2つに分けて考えます。検索が正解を持ってこられたかと、生成が渡された内容どおりに答えたかです。
- 検索の側
想定した質問に対して、正解が含まれるチャンクが取り出せているかを見ます。取り出した件数のうち、何件目に入っていたかも記録します。 - 生成の側
渡された資料に沿っているかに加え、質問に答えているか、重要な条件や例外を落としていないかを確認します。表示した出典が実在し、その回答を裏付けているかも見ます。 - 答えない判断
資料に答えがない質問を混ぜておき、「分からない」と返せるかを確認します。あわせて、答えられる質問まで過剰に保留していないかも見ます。どちらかに寄ると使いにくくなります。
検索と生成を分けて測るのは、切り分けのためです。合計の正答率だけを見ていると、どちらを直せばよいか分かりません。
根拠への忠実さだけでなく、関連性や完全性も分けて見ます。評価の観点の立て方は、MicrosoftのRAGの回答評価の資料が参考になります。
継続して測る体制
一度測って終わりにすると、資料が増えたときに気づかないまま精度が下がります。測る頻度と担当を決めておきます。
現場から「違う答えが返った」という指摘が来たときに、その質問を評価の組に追加していく形が実際的です。使われるほど評価の組が育ち、次の変更で比べられるようになります。
変更の記録も残します。チャンクの大きさを変えたのか、取り出す件数を変えたのか、プロンプトを直したのか。記録がないと、良くなった理由も悪くなった理由も分からなくなります。
PoCで確かめること
小さく試す段階では、精度の数字よりも先に確かめておくことがあります。
対象の資料が、そもそも機械で読める状態かどうか。スキャンした画像のPDFや、レイアウトが複雑な文書が多い場合は、読み取りが最初の壁になります。
想定していた質問が、実際に現場から出る質問と合っているか。質問の想定のずれは、利用する人に実際に使ってもらうことで分かります。社内で使われない仕組みになる原因は、精度よりも質問の想定のずれにある場合もあります。
チャットボットが使われなくなる要因については、誰にも使われないチャットボットを作ってしまう危険性の記事でも扱っています。
構築方法の選び方
御社で組むか、既にあるものを使うかの判断です。順序を決めておくと、検討が進みます。
既製のサービスから検討する
まず、既製のサービスの標準機能で必要な条件を満たせるかを確認します。社内文書の検索に対応したサービスは複数あり、文書を置くだけで使える形のものもあります。
確認する点は、扱える文書の形式、権限による出し分け、出典の表示、評価の記録です。満たせない項目が出たら、オプションや連携で補えるかを調べます。
個別開発を検討する範囲
既製のサービスで足りない条件がある場合に、個別開発の範囲を検討します。既存の業務システムと組み合わせる場合や、権限の分け方が複雑な場合が当てはまります。
検索の方式を資料の性質に合わせて調整したい場合も、個別開発の範囲に入ります。固有の値を多く含む文書や、条文の構造を持つ文書では、検索方式の調整によって必要な箇所を取り出せるかが変わります。
費用は、必要な機能に加えて、公開後の保守や運用も含めて比較します。資料が変わるたびに取り込みをやり直す運用になるため、その手間も見積もりに入れておきます。
開発を外部に頼む場合の考え方は、AIエージェントの活用事例と開発会社の選び方をまとめた記事でも扱っています。
切り替えにかかる負担も見ておく
既製のサービスで始めて、足りなくなったら個別開発に移る進め方は取れます。ただし、取り込んだ資料やチャンクの設定をそのまま移せるかはサービスによって違います。
資料の取り込み直しが必要になる前提で考えておくと、見込み違いが減ります。評価の組を自分たちの手元に残しておけば、移したあとも同じ基準で比べられます。
EnlytのAI開発の取り組み
Enlyt(エンライト)では、AIのR&D(研究開発)に取り組んでいます。ベトナム拠点である株式会社SupremeTechのエンジニアと連携する体制です。
R&Dチームの体制については、ベトナム拠点のCEOへのインタビューでも触れています。
社内規程への自動回答の開発事例
ホームセンターを運営する株式会社グッデイ様では、社内規程に関する質問に自動で回答する仕組みの開発をEnlytで担当しました。人事総務部への問い合わせ対応にかかる工数を減らすことが目的です。
過去の開発実績と今回の依頼内容から、既存の機械学習サービスでは必要な精度を得ることが難しいと判断しました。LangChainなどを用いた個別開発で検証しています。
構成はPostgreSQLとpgvectorでベクトルを保持し、LangChainとOpenAIのAPIで回答を生成する形です。利用者が使う画面はGoogle Chatにしています。
結果として、マニュアルで資料を探す手間と、人事総務部にかかる工数を削減できました。詳細は株式会社グッデイ様のAIチャットボット開発でご紹介しています。
実装例の公開
社内文書を検索し、関連する内容を生成AIに渡すチャットボットの実装例も公開しています。文書を意味のまとまりで分割してベクトルに変換し、質問との類似度から該当箇所を取り出してプロンプトに渡す形です。
サンプルコードを含めた内容は、社内データを学習させたAIチャットボットの開発の記事でご紹介しています。
構築を検討する段階で整理しておくこと
構築を検討する際は、対象資料の範囲と、何を正解とするかを先に整理します。この2つが決まっていないと、作ったあとで評価ができず、改善の方向も定まりません。
範囲を絞って試作し、評価用の質問で確かめてから対象を広げる進め方が考えられます。測れる状態にしてから広げるほうが、手戻りが少なくなります。
なお、AIを使うと動くものが早くできる一方で、見落とされやすいリスクもあります。この点はAI開発で見落とされがちなリスクの記事にまとめています。
対象の資料の棚卸し、評価の組の作り方、既製のサービスで足りるかの切り分け。どこから手を付けるか整理したい段階でも、ご相談を受け付けています。
よくある質問
資料が整理されていない状態でも始められるか
始められますが、精度は元の資料の状態に左右されます。古い版や矛盾した記述が混ざっていると、どちらが返るかが安定しません。
範囲を絞って、整っている資料から始める進め方を勧めます。対象を広げるのは後からできます。
スキャンしたPDFは使えるか
文字の層が入っていれば読めます。入っていない画像のままのPDFは、画像から文字を取り出す処理を通す必要があります。
取り出した文字に誤りが混ざると、その誤りを多少はAIが修正したとしても、検索と回答に使われ影響します。対象に含める場合は、取り出した結果を確認する工程を入れます。
どのくらいの資料量が必要か
RAGで求める回答が正しく出力されるために必要な資料の量は、資料の量よりも、答えてほしい質問に対応する記述が資料内にあるかどうかです。少ない資料でも、質問の範囲と合っていれば機能します。
逆に、量を増やしても質問に関係のない文書であれば、検索で邪魔になります。
誤回答をゼロにできるか
できません。RAGは誤回答を減らす仕組みで、なくす仕組みではありません。
誤回答への対策として、2つを設計に入れます。出典を示して利用する側が確かめられるようにしておくことと、資料に答えがない場合は分からないと返すことです。
人の確認を挟むか、自動で表示するかは、誤回答が与える影響に応じて決めます。自動表示する場合は、回答を保留する条件と、担当者へ引き継ぐ方法を設計します。
資料を更新したときはどうなるか
更新した文書を取り込み直す必要があります。自動で取り込む仕組みを作らない場合は、誰がいつ行うかを運用として決めておきます。
取り込み直しの担当と頻度を決めないまま始めると、古い内容が返り続ける状態になります。更新の頻度が高い資料を対象にする場合は、設計の段階で扱いを決めます。
まとめ
RAGは、質問に関係する文書を先に検索し、その内容を根拠としてAIに答えさせる仕組みです。処理は取り込み、検索、生成の3段階に分かれます。どこで何が起きているかは切り分けられます。
誤った回答が出たときに調べるのは、元の資料、取り込み・分割、検索、回答生成の4か所です。これに、修正の効果を確かめる評価・変更管理を加えた5つが確認点です。
どこに原因があるかを確かめないまま手を打つと、効かない対策に時間を使うことになります。
起点は、回答の根拠に使われた箇所を確認することです。資料自体が正しいか、その質問に適用できる内容かを調べ、正しければ後ろの段階で条件が落ちていないかを見ます。
構築の前に決めておくのは4つです。対象にする資料の範囲、誰に使わせるか、何を正解とするか、どこまでの精度で運用に乗せるかです。このうち評価の組は、構築のあとではなく前に用意します。
閲覧権限に応じた制御も、後から追加すると設計の見直しが必要になる場合があります。見せられない資料がある環境では、最初の設計に入れておきます。
方法は、既製のサービスで必要な条件を満たせるかを確認し、足りない範囲を個別開発で検討する順序です。切り替えの手間も含めて比べると、見込み違いが減ります。
Enlytでは、対象資料や利用者の範囲、既存システムとの連携の有無を伺い、必要な機能と進め方をご提案しています。既製サービスで条件を満たせるかも確認します。
資料や質問の内容によっては、RAGを構築するより、資料の整理や検索環境の改善が目的に合う場合もあります。選択肢ごとの利点と注意点を整理しながら検討します。
受注前の無料コンサルティングもご用意しています。何を作るか決まっていない段階でもご相談ください。
AIを使った仕組みづくりなら、私たちEnlytにお任せください!
どの資料を対象に、誰が何を聞く仕組みにするか。目的から逆算して、検証できる範囲から組み立てます。受注前の無料コンサルティングもご用意しています。小さなことでもお気軽にご相談ください。